
La ciencia de datos está transformando el deporte: calcula probabilidades de victoria, analiza el desempeño de los jugadores y ayuda a prevenir lesiones. Pero también abre interrogantes sobre la privacidad, la ética y el poder de los clubes sobre la información de sus deportistas.
En Alcanzando el Conocimiento exploramos la competencia entre inteligencia artificial, experiencia profesional y sabiduría colectiva. Porque los datos pueden cambiar el juego, pero no eliminan la incertidumbre.
La ciencia de datos permite calcular probabilidades de victoria, evaluar el desempeño de los jugadores y diseñar estrategias; sin embargo, su avance también plantea preguntas sobre la privacidad, la ética y los límites de las predicciones. En el deporte, el reto ya no es solamente ganar, sino comprender qué información puede ayudar a conseguirlo.
Durante décadas, las decisiones deportivas dependieron de la experiencia de los entrenadores, la observación de los jugadores y la intuición de quienes han dedicado su vida a entender el juego. Hoy, una nueva herramienta está cambiando las reglas: la ciencia de datos.
En el fútbol y el futbol americano, miles de observaciones pueden convertirse en modelos estadísticos capaces de identificar patrones, estimar probabilidades de victoria, evaluar el rendimiento de un deportista y anticipar escenarios de competencia.
La transformación no consiste únicamente en acumular estadísticas. El verdadero desafío es convertirlas en conocimiento útil para tomar mejores decisiones.
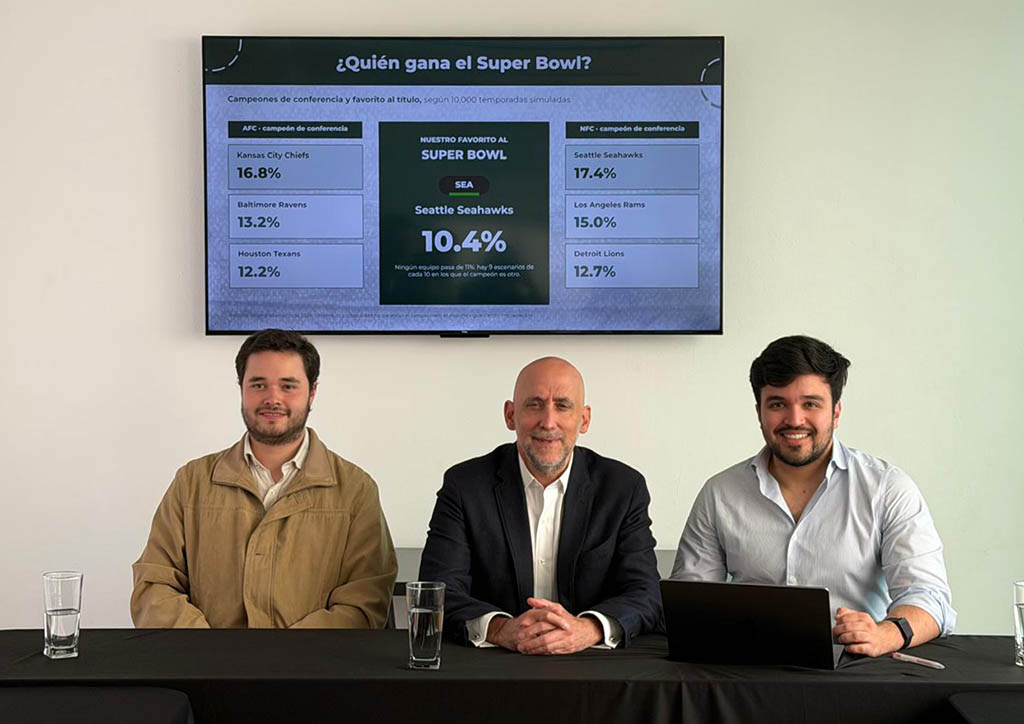
Ese es uno de los objetivos de ISAC, una iniciativa que busca profesionalizar la analítica deportiva y desarrollar talento especializado en México y América Latina. Durante la presentación de ISAC Bot NFL, sus integrantes mostraron cómo los modelos matemáticos pueden trasladar el análisis de datos al terreno de las predicciones deportivas y poner a prueba su capacidad frente a la realidad.
Del campo de juego al laboratorio de datos
La analítica deportiva comienza con la recolección de información. Mediante tecnologías como la visión por computadora y los sistemas GPS, es posible registrar decenas de miles de observaciones durante un partido.
Los datos pasan después por distintas etapas: los analistas estudian el comportamiento de los equipos y formulan hipótesis; los especialistas en ciencia de datos las someten a pruebas estadísticas, y los resultados se presentan de manera comprensible a quienes deben tomar las decisiones, entre ellos los directores técnicos.
El proceso permite estudiar el desempeño individual, analizar a los rivales, identificar oportunidades tácticas, evaluar posibles fichajes y estimar la eficiencia de determinadas estrategias.
En el futbol americano, ISAC Bot NFL utiliza datos oficiales de la liga correspondientes al periodo 2015-2026, incluidos resultados, información jugada por jugada, plantillas, selecciones del draft y lesiones. Con esa información calcula la fuerza relativa de los equipos mediante un sistema de rating Elo, estima su eficiencia y ejecuta simulaciones de Monte Carlo.
El modelo realiza 10 mil simulaciones de temporadas completas, incluidos el calendario oficial y los playoffs, para estimar las probabilidades de victoria y de campeonato.
La diferencia entre decir que un equipo es favorito y calcular que tiene determinada probabilidad de ganar es fundamental: el modelo no ofrece una certeza sobre el futuro, sino una estimación construida a partir de los datos disponibles y de los supuestos de su diseño.
¿Puede una máquina saber más que los expertos?
Una de las preguntas más interesantes surge cuando las predicciones de un algoritmo se enfrentan a las de comentaristas deportivos y aficionados.
ISAC presentó los resultados de su modelo durante el Mundial de 2026. De acuerdo con la información expuesta, su pronóstico ubicó a España como campeona, a Argentina como subcampeona y a Inglaterra en tercer lugar, exactamente el podio que finalmente se registró.
El resultado es llamativo, aunque un acierto no basta por sí solo para demostrar la superioridad general de un modelo. Para evaluar su calidad es necesario analizar su desempeño en múltiples torneos, contrastar sus probabilidades con los resultados y compararlo con otros métodos.
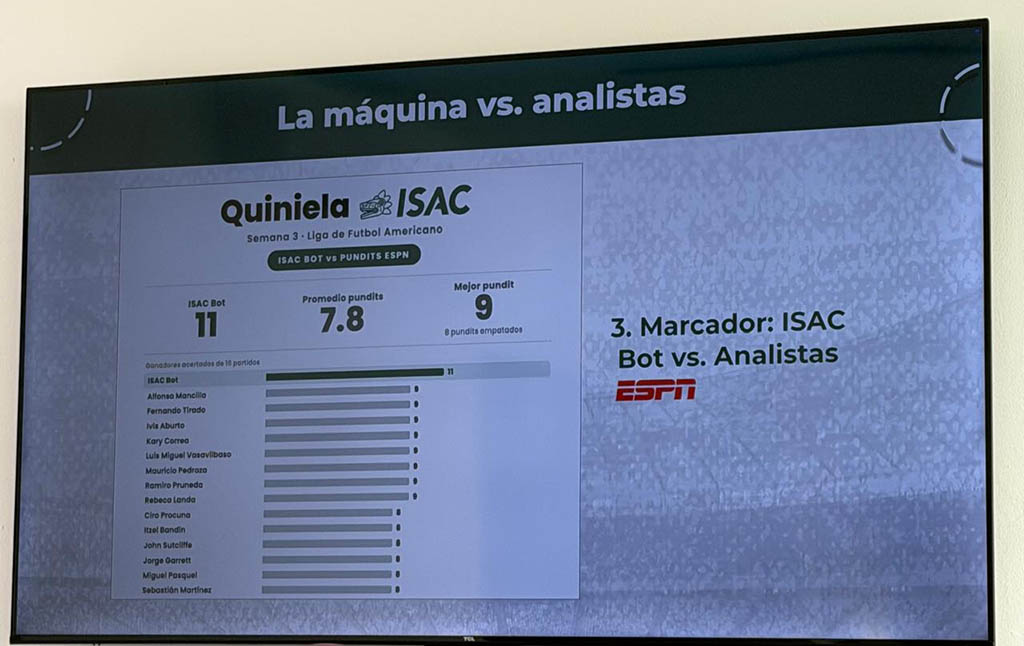
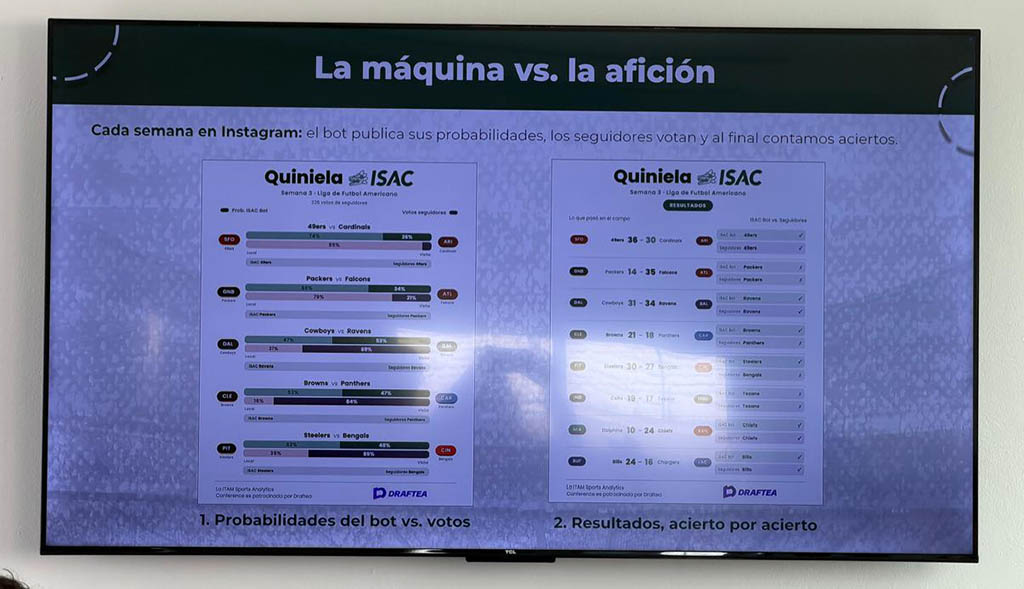
En la NFL, el experimento adquirió una dimensión adicional: enfrentar al bot con analistas televisivos y con las votaciones de los seguidores.
Durante la tercera semana de la temporada 2026, ISAC Bot acertó 11 de los 16 partidos analizados, equivalentes a 69 por ciento. Según la presentación, superó a los 24 analistas televisivos considerados en esa comparación y acertó los tres encuentros en los que eligió al equipo contrario al preferido por la mayoría.
En el acumulado de las primeras tres semanas, el modelo acertó 28 de 45 partidos, es decir, 62 por ciento. Cuando asignó una probabilidad de al menos 65 por ciento a un equipo, acertó en 11 de 15 ocasiones.
Los propios responsables del proyecto advierten que tres semanas constituyen una muestra pequeña y que el modelo se actualiza con cada jornada.
La cautela es importante: acertar en una muestra limitada no garantiza el mismo desempeño en el futuro. La evaluación rigurosa requiere observar más partidos, medir la calibración de las probabilidades y comprobar si el modelo conserva su rendimiento frente a circunstancias cambiantes.
Pero el experimento permite plantear una pregunta de mayor alcance: ¿qué sucede cuando una predicción estadística contradice la opinión de la mayoría?
La máquina frente a la sabiduría de las masas
La llamada sabiduría de las masas es un fenómeno estudiado en ciencias sociales y economía del comportamiento. Bajo determinadas condiciones, la combinación de numerosos juicios individuales puede producir estimaciones sorprendentemente acertadas, incluso cuando ninguna persona posee toda la información necesaria para resolver un problema.
La clave está en que las opiniones incorporen información diversa y que los errores individuales no sean exactamente iguales. Cuando los participantes dependen de las mismas fuentes, imitan a los demás o comparten sesgos, la inteligencia colectiva puede perder parte de su ventaja.
En el deporte, la afición reúne conocimientos que no siempre son fáciles de cuantificar: observa el estado de ánimo de un equipo, recuerda actuaciones anteriores, interpreta decisiones tácticas y reconoce contextos que pueden escapar a una base de datos.
Sin embargo, también puede sobrevalorar a sus jugadores favoritos, dejarse llevar por una victoria reciente o confundir popularidad con rendimiento.
Un algoritmo enfrenta el problema desde otra perspectiva. En lugar de dejarse llevar por la narrativa de una temporada, combina variables y estima probabilidades de acuerdo con relaciones que pueden ponerse a prueba.
Ninguno de los dos enfoques es infalible.
La comparación entre ISAC Bot, los analistas y los seguidores puede ayudar a distinguir entre tres formas de conocimiento: la experiencia profesional, la inteligencia colectiva y el análisis cuantitativo.
Para saber cuál funciona mejor, no basta con contar los aciertos de una jornada. También es necesario comparar las probabilidades emitidas antes de los partidos, evaluar los resultados a largo plazo y determinar en qué condiciones cada método ofrece mejores estimaciones.
La pregunta, entonces, no es si debemos elegir entre personas y máquinas, sino cómo combinar sus fortalezas sin confundir una probabilidad con una certeza.
Prevenir lesiones: cuando los datos entran en la vida privada
La aplicación de la ciencia de datos adquiere una dimensión más delicada cuando deja de utilizarse para pronosticar resultados y comienza a intervenir en la salud y el rendimiento de los deportistas.
Durante la discusión sobre analítica deportiva se explicó que la prevención de lesiones es una de las áreas de crecimiento, pero también una de las que enfrenta mayores obstáculos éticos y regulatorios.
Los modelos pueden ayudar a estudiar las cargas físicas acumuladas, la intensidad de los entrenamientos y las exigencias de la competencia. Con esa información, el personal especializado puede valorar cuándo conviene reducir la carga de trabajo, modificar una sesión o sustituir a un jugador que no está en condiciones óptimas para completar un partido.
Un ejemplo compartido durante la conferencia fue la experiencia de trabajo con un club de la Liga MX. El equipo estudiaba en qué momentos del entrenamiento los futbolistas realizaban mayores esfuerzos y utilizaba métricas para estimar las cargas físicas acumuladas. Esa información contribuía a tomar decisiones sobre los cambios durante los partidos y la administración del esfuerzo.
El objetivo, se subrayó, no era predecir con certeza quién sufriría una lesión, sino prevenirla.
La distinción es relevante. Un modelo puede identificar señales de riesgo o patrones asociados con una mayor exigencia física, pero eso no significa que pueda anticipar con precisión qué jugador se lesionará, cuándo ocurrirá o cuál será la causa.
Además, la información necesaria para estos análisis puede ser extremadamente personal: hábitos de sueño, alimentación, condiciones físicas y datos psicológicos.
Durante la conferencia se mencionó que el Club América cuenta con un tablero de seguimiento para la prevención de lesiones que integra información de esta naturaleza. También se señaló que el acceso y la interpretación de los datos deben permanecer bajo controles adecuados y en manos de personal especializado.
De acuerdo con los participantes, solamente tres clubes de México realizan este tipo de trabajo, aunque la cifra corresponde a lo señalado durante la exposición y no a un censo independiente de todos los equipos profesionales.
La razón de mantener la información dentro de cada club no es únicamente tecnológica. También es ética y económica.
Un futbolista representa una inversión importante para su equipo, pero es, ante todo, una persona cuyos datos pueden afectar su carrera profesional. Si información sobre su salud, sus hábitos o su posible riesgo de lesión circulara libremente entre clubes, podría utilizarse para condicionar un fichaje, negociar un contrato o justificar una decisión laboral.
Por eso, los especialistas plantearon que la protección de estos datos es indispensable y que no sería ético compartirlos sin las salvaguardas correspondientes.
La paradoja es evidente: la misma información que puede ayudar a cuidar a un deportista también podría convertirse en una herramienta para discriminarlo.
¿Quién controla los datos y quién se beneficia?
El avance de la analítica deportiva abre una discusión sobre la propiedad, el acceso y el uso de la información.
¿Quién debe decidir qué datos se recogen? ¿Qué autorización necesita un club para procesar información relacionada con el sueño o la salud mental de un jugador? ¿Cuánto tiempo puede conservarla? ¿Qué ocurre cuando termina el contrato? ¿Puede un deportista conocer y cuestionar las conclusiones de un modelo que influye en su carrera?
Son preguntas que requieren políticas claras, consentimiento informado, controles de acceso y mecanismos de supervisión. También exigen distinguir entre los datos necesarios para mejorar el rendimiento y aquellos cuya recolección puede resultar excesiva.
La confidencialidad no debería verse como un obstáculo para la innovación, sino como una condición para que esta sea legítima.
En el terreno deportivo, la ciencia de datos tiene la posibilidad de ayudar a reducir riesgos, mejorar entrenamientos y aprovechar mejor el talento. Pero su utilidad no elimina la responsabilidad de quienes deciden cómo utilizarla.
El deporte no pierde su incertidumbre
La expansión de estas herramientas muestra que la ciencia de datos ha dejado de ser un recurso exclusivo de unos cuantos equipos para convertirse en una capacidad cada vez más importante en la industria deportiva.
Su potencial no se limita al resultado de un partido. También alcanza la selección de jugadores, el diseño de estrategias, la administración de cargas físicas y la relación de los clubes con sus aficionados.
Sin embargo, el deporte conserva una característica que ningún modelo puede borrar: la posibilidad de que ocurra lo inesperado.
Una lesión, una decisión táctica, un error individual o una jugada extraordinaria pueden alterar un resultado que parecía probable. Precisamente por eso, una predicción responsable debe expresar incertidumbre, no ocultarla.
El desafío científico consiste en construir modelos que puedan evaluarse, corregirse y mejorar con nueva evidencia. El desafío humano es impedir que sus resultados se conviertan en verdades incuestionables.
La ciencia de datos no sustituye automáticamente al entrenador, al analista ni a la afición. Les ofrece otra manera de observar el juego, contrastar intuiciones y tomar decisiones.
En última instancia, la verdadera competencia no es entre la máquina y la sabiduría de las masas. Es entre las decisiones que se apoyan en evidencia, reconocen sus límites y pueden corregirse, y aquellas que confunden una corazonada o un cálculo con una verdad absoluta.
En el deporte, como en la ciencia, ganar también significa aprender a equivocarse mejor.